Firma tworząca oprogramowanie AI: prywatne LLM i AI w Twoim produkcie

Jesteśmy firmą tworzącą oprogramowanie AI, która buduje funkcje oparte na modelach językowych w produktach webowych i mobilnych. Dla PSONI hostujemy otwarty model na wynajmowanych serwerach GPU, a dla Centrum Komunikacji dodaliśmy transkrypcję mowy na żywo do platformy polskiego języka migowego.

Bezpłatne warsztaty discovery o AI

Opowiedz nam, co budujesz.

Kilka szczegółów pozwoli nam przyprowadzić na pierwszą rozmowę właściwych inżynierów.

  • Projekty software'owe

    160+

    we wszystkich branżach

  • Zespół

    40+

    na pełen etat

  • Użytkownicy aplikacji

    40 000+

    we wszystkich naszych projektach

Gdzie działa model i kto sprawdza jego wyniki

Teksty wklejane do aplikacji mogą być osobiste, dlatego PSONI nie mogło wysyłać ich do publicznego API AI. Automatyczne napisy mylą imiona, adresy i nazwy leków, dlatego w Centrum Komunikacji poprawia je człowiek. Takie sytuacje decydują o tym, jak powstaje funkcja AI: gdzie działa model, kto sprawdza jego wyniki i co go otacza.

Enerace

Co automatyzuje AI w produktach, które budujemy

AI przejmuje powtarzalne czytanie i pisanie wokół produktu, a decyzje zostają po stronie ludzi. Enerace.Online, platforma doradcza dla przemysłowych odbiorców energii i gazu, którą budujemy i rozwijamy od 2020 roku, od 2025 roku pokazuje podsumowanie AI pod każdą wiadomością rynkową. Funkcja pojawiła się bez przepisywania platformy, która ma ponad 20 obszarów funkcjonalnych.

Firma tworząca oprogramowanie AI
  1. Podsumowanie

    Każda wiadomość przypięta do wykresu cen dostaje krótkie podsumowanie po angielsku i po polsku, tworzone w chwili dodania wiadomości.

  2. Towar i miejsce

    Model przypisuje jeden z 9 typów towarów i jeden z 38 krajów lub regionów.

  3. Kierunek rynku

    Ocena: wzrost, spadek lub bez zmian, z krótkim uzasadnieniem. To ocena modelu, którą potwierdza człowiek.

  4. Tekst i zadanie w tle

    Crawler pobiera tekst, a przeglądarka służy jako rozwiązanie zapasowe. Gdy to zawiedzie, redaktor wkleja tekst ręcznie, a generowanie uruchamia Celery.

Jak przebiega projekt

Usługi tworzenia oprogramowania AI: od discovery do utrzymania

Projekt oprogramowania AI przebiega w pięciu krokach: discovery, proof of concept, MVP, uruchomienie i wsparcie, a każdy odpowiada na jedno pytanie. W discovery dobieramy też model i serwery GPU do spodziewanego ruchu, a czasem wynikiem jest rada, by w ogóle zrezygnować z modelu językowego.

  1. Discovery

    Jedno bezpłatne spotkanie, które kończy się zakresem, wyceną i testem sukcesu. Sprawdzamy produkt, dane, zasady i zadanie. Sesję wspiera nasz własny zestaw narzędzi AI.

    Bezpłatnie

  2. Proof of concept

    Czy model poradzi sobie z tym zadaniem wystarczająco dobrze na Twoich danych? Próbki testowe i miara jakości powstają przed pierwszym promptem. PSONI zaczęło tutaj, od pierwszego promptu i skryptu oceniającego czytelność.

    Jedno pytanie

  3. MVP

    Backend, konta oraz aplikacje webowe i mobilne wokół modelu, z nadal działającymi miarami z proof of concept. Generator ETR dla PSONI jest w etapie V z ośmiu.

    Prawdziwi użytkownicy

  4. Uruchomienie

    Funkcja produkcyjna, którą możesz oglądać w działaniu, sprawdzana miarami ustalonymi wcześniej. Podsumowania AI w Enerace działają od 2025 roku.

    Na żywo

  5. Wsparcie

    Utrzymanie, gdy zmieniają się modele, prompty i dane, aby funkcja działała dalej zgodnie z założeniami. Platforma remontowa jest naszym klientem od maja 2022 roku.

    Stale

Modele językowe, które zostają na Twoich serwerach

Prywatny LLM to model językowy działający na serwerach, które kontrolujesz Ty lub Twój dostawca hostingu, więc teksty, które czyta, nigdy nie trafiają do publicznego API AI. Ten sam zestaw, czyli otwarty model, vLLM i aplikacja wokół nich, może działać na Twoich serwerach, jeśli mają odpowiednie karty GPU, albo u dostawcy chmury w regionie wymaganym przez Twoje zasady. Nasza strona o wdrożeniach LLM on-premise opisuje te opcje, a słownik wyjaśnia, czym samodzielnie hostowane LLM różnią się od modeli dostępnych przez API.

PSONI, Polskie Stowarzyszenie na Rzecz Osób z Niepełnosprawnością Intelektualną, wybrało tę drogę dla Generatora ETR. Wklejane teksty mogą być osobiste, więc publiczne API odpadło. Proof of concept porównał PLLuM 12B, polski model językowy, z wersją mixture-of-experts 26B modelu Gemma 4 na jednym zadaniu upraszczania tekstu, a Gemma 4 dała lepsze wyniki na danych projektu. Serwujemy ją przez vLLM na serwerach GPU, które wynajmujemy, więc żaden tekst nie trafia do API dostawcy AI.

Skrypty wdrożeniowe uruchamiają instancję GPU, instalują vLLM z wagami Gemma 4 i udostępniają API zgodne ze specyfikacją OpenAI. Od września 2026 roku, przed testami akceptacyjnymi PSONI, środowisko stagingowe działa na stałej mocy GPU, więc model pozostaje dostępny, nawet gdy dostawca odbierze wynajętą instancję.

Ile pamięci GPU potrzebuje Gemma 4 26B A4B

Model aktywuje około 4 miliardów parametrów na token, ale wszystkie 26 miliardów musi mieścić się w pamięci GPU. To dane z dokumentacji Google, a serwery GPU dobieramy właśnie do takich wartości.

26 mld

parametrów w pamięci GPU, choć na token aktywnych jest około 4 miliardów

57,7 GB

w precyzji 16-bitowej, bez pamięci podręcznej aktywnych rozmów

14,4 GB

w kwantyzacji 4-bitowej, która zapisuje wagi z niższą precyzją liczbową

Prywatny LLM czy publiczne API AI

Prywatny LLM i publiczne API AI w porównaniu
PytaniePubliczne API AIPrywatny LLM
Dokąd trafiają dane?Każdy prompt i dokument opuszcza Twoją infrastrukturę i trafia na serwery dostawcyTeksty zostają na serwerach, które kontrolujesz Ty lub Twój dostawca hostingu
Jakiej wersji modelu używasz?Dostawca wycofuje stare wersje według własnego harmonogramuPrzetestowana wersja otwartego modelu zostaje tak długo, jak jej potrzebujesz
Co trzeba dobrać?Nic po Twojej stronie, bo moc zapewnia dostawcaMoc GPU na podstawie liczby równoczesnych zapytań i testu obciążenia na realistycznych dokumentach
Jakiej jakości się spodziewać?Największe modele są lepsze w zadaniach ogólnychNajlepsza na wąskim zadaniu z własną oceną jakości
Co utrzymuje działanie?DostawcaPrzypięta wersja modelu, health check z automatycznym restartem, limity czasu, maksymalny rozmiar wejścia, limit kolejki i zapisana licencja wag
Kto się tym opiekuje?DostawcaTy albo my w ramach wsparcia i utrzymania

Agenci AI i chatboty

Agent AI to model językowy, który potrafi wywoływać narzędzia, takie jak wyszukiwanie w danych produktów, i prowadzić rozmowę do wyniku. Chatbot odpowiada, a agent dodatkowo działa za pomocą narzędzi, które dostał.

Jeden z naszych wieloletnich klientów, który pozostaje anonimowy, prowadzi platformę produktową dla rynku remontów i wykończeń wnętrz, a my współpracujemy z nim od maja 2022 roku. System zarządza remontami i wykończeniem nieruchomości: zamawianiem produktów, wyszukiwarką wspieraną przez AI, zarządzaniem pracami i komunikacją z wykonawcami. Powstał w Pythonie, Django i Django REST Framework, a czat AI w aplikacji i agent wyszukujący produkty działają dziś produkcyjnie.

Agent przeszukuje jednocześnie teksty i metadane wielu produktów z ofert wielu dostawców. Część pracy przeszła z modelu do kodu w Pythonie, by była powtarzalna: kod buduje zapytanie wyszukiwania, więc to samo pytanie zawsze daje tę samą odpowiedź, a model prowadzi rozmowę. Gdy wyszukiwanie nic nie znajdzie, agent powtarza je ze zmienionymi parametrami.

Przy pytaniu o cenę agent pobiera cenę, a odpowiedź zawiera adres źródłowy produktu. Każda wiadomość do AI niesie kontekst klienta, imię i numer telefonu, dzięki czemu rozmowa może przejść do obsługi klienta. Nasza strona o tworzeniu agentów AI wyjaśnia, jak projektujemy agentów, a hasło słownika o MCP opisuje protokół, którym agenci docierają do systemu.

Integracja

Integracja AI z istniejącym produktem

Integracja AI to dodanie funkcji opartej na modelu do działającego już produktu bez jego przebudowy. Backend wywołuje osobną usługę AI, która łączy się z modelem i może udostępniać swoją pracę innym systemom oraz agentom.

  1. Produkt

    • Aplikacje webowe i mobilne Tu użytkownicy spotykają funkcję AI.
    • Warstwa usług backendu Wywołuje usługę AI, dzięki czemu część AI można mierzyć, zmieniać lub wyłączać osobno.
  2. Usługa AI

    • Osobna usługa AI Obsługuje funkcję samodzielnie. Na platformie remontowej włącza ją i wyłącza flaga ai_enabled.
    • Kontrole jakości Miary ustalone przy proof of concept działają dalej po uruchomieniu.
  3. Model

    • API dostawcy Szybszy start. Pasuje, gdy dane mogą opuścić Twoją infrastrukturę.
    • Model hostowany przez nas Otwarty model serwowany przez vLLM. Pasuje, gdy dane nie mogą trafić do dostawcy.
  4. Inne systemy

    • API dla innych systemów Kilka produktów lub zespołów korzysta z jednej funkcji AI przez interfejs.
    • Serwer MCP Agenci AI wywołują funkcje produktu z kontrolowanym dostępem, tak jak na naszym własnym serwerze MCP.

Wyróżnione: model hostowany

Wybór drogi zależy od tego, dokąd mogą trafiać dane: do API dostawcy czy do modelu, który hostujemy. Resztę rozstrzyga to, czy inne produkty lub agenci potrzebują tej funkcji. Oba pytania zamykamy w discovery.

AI dla dostępności: transkrypcja mowy na żywo dla osób głuchych i słabosłyszących

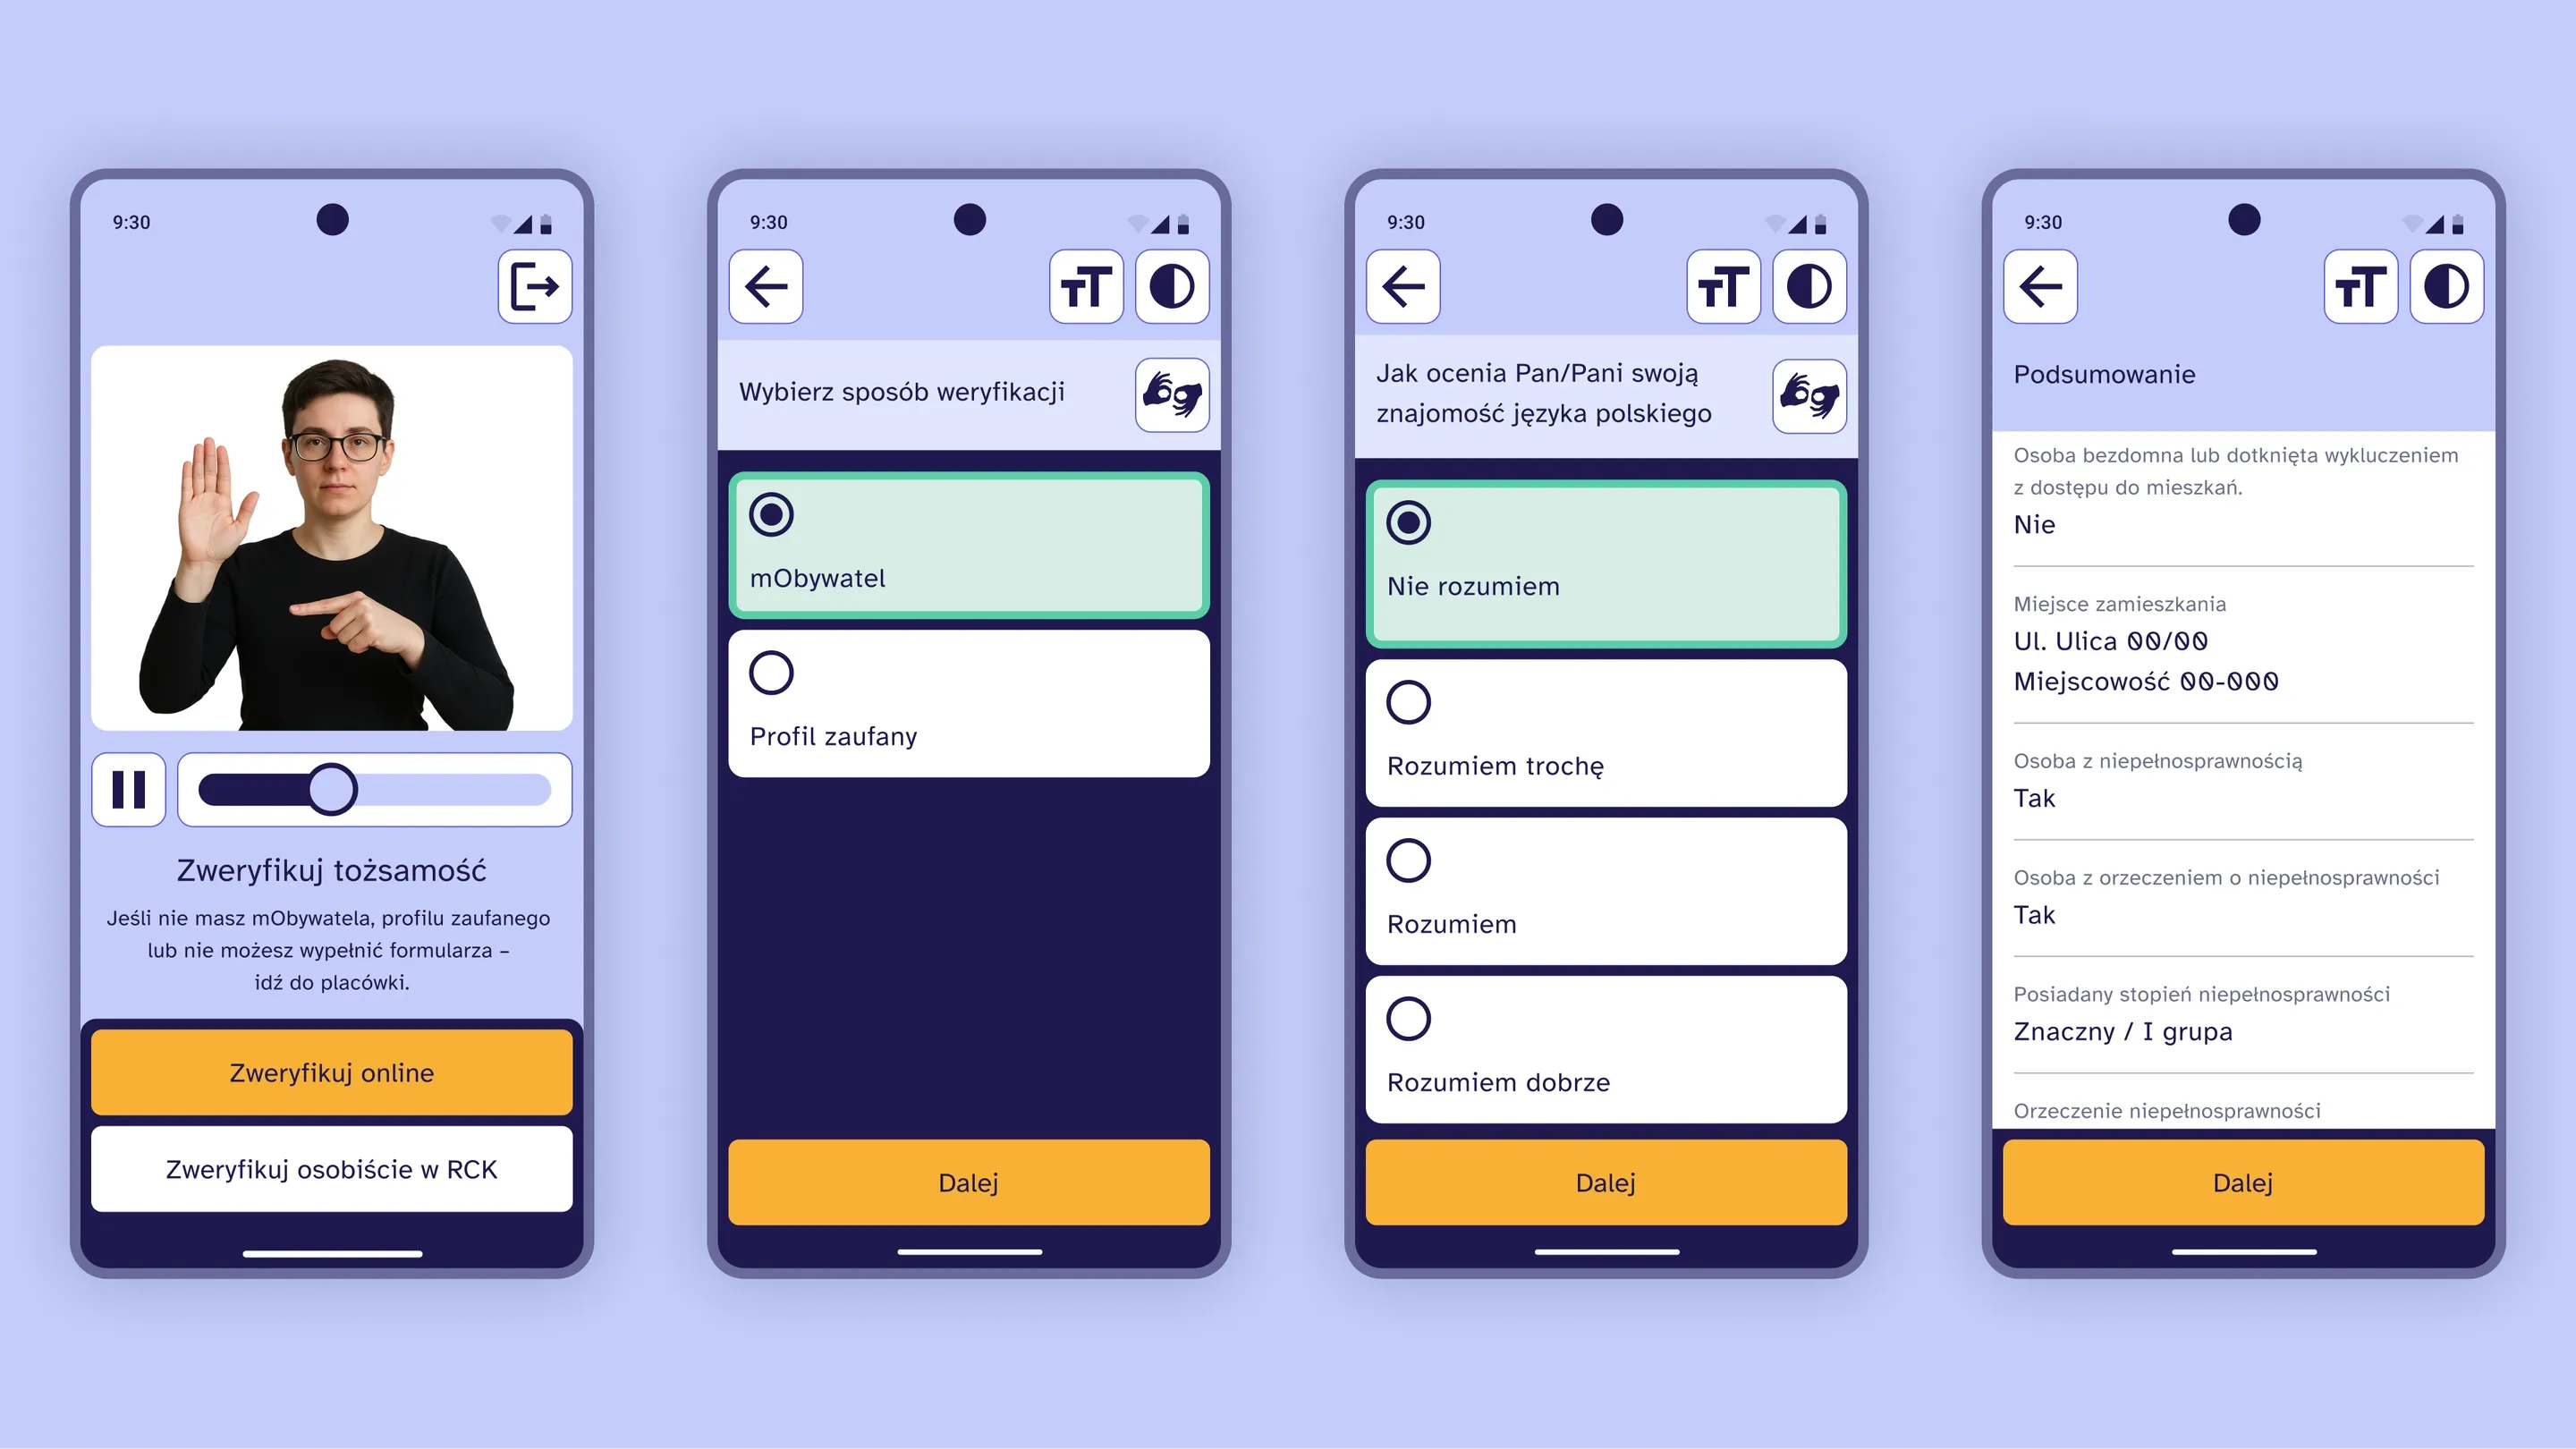
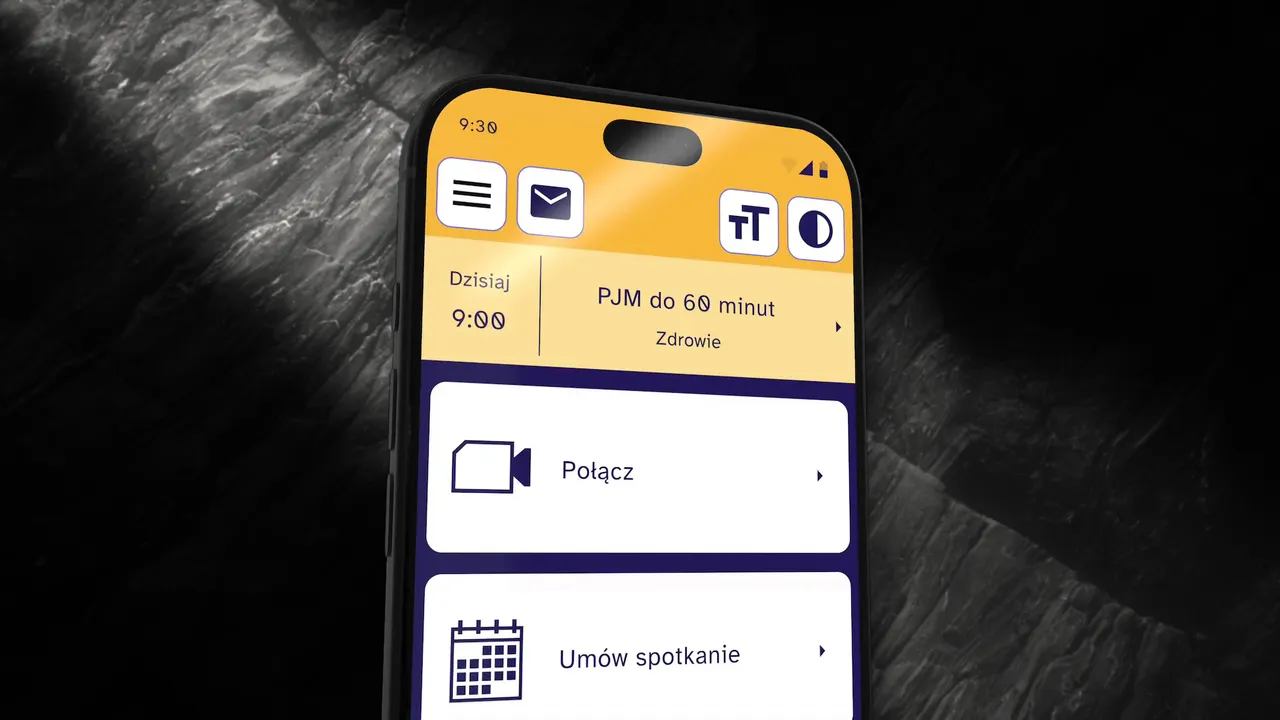
AI dla dostępności, nazywane też accessibility AI, udostępnia treści osobom, które nie mogą z nich korzystać w pierwotnej postaci, na przykład zamieniając mowę na tekst. Centrum Komunikacji robi to na żywo, produkcyjnie, dla osób głuchych i słabosłyszących. Polski Związek Głuchych prowadzi tę platformę tłumaczeń na polski język migowy (PJM), finansowaną z programu Fundusze Europejskie na rzecz Rozwoju Społecznego 2021-2027. Aplikacja webowa i mobilna obsługuje osoby głuche, głuchoniewidome i niewidome: rozmowy audio i wideo, czat, historię i kolejkowanie.

Warsztaty z klientem odbyły się w lipcu 2025 roku, a platforma weszła na produkcję 20 kwietnia 2026 roku, dziewięć miesięcy później. Transkrypcja mowy na żywo dla osób słabosłyszących i ogłuchłych w dorosłym życiu to jedna z funkcji, które dodaliśmy. Sesja trwa do 30 minut i jest dostępna od ręki, w granicach dostępności specjalisty. Pełną historię opisuje case study Centrum Komunikacji.

Firma tworząca oprogramowanie AI

Automatyczne napisy mylą imiona, adresy i nazwy leków, więc poprawia je człowiek

Droga jednego zdania:

  • Vosk z polskim modelem zapisuje pierwszy szkic w przeglądarce specjalisty
  • Specjalista od transkrypcji poprawia szkic w trakcie rozmowy
  • Do użytkownika jako wiadomość czatu trafia tylko poprawiony tekst
  • Szkic i zatwierdzony tekst mają w interfejsie różne kolory
  • Klient, specjalista i osoba po drugiej stronie telefonu dostają osobne strumienie
  • Osoba słabosłysząca może też zadzwonić, a specjalista transkrybuje drugą stronę

AI dla dostępności: teksty łatwe do czytania dla osób z niepełnosprawnością intelektualną

Generator ETR to aplikacja webowa i mobilna dla PSONI, która zamienia trudny tekst, na przykład pismo urzędowe, na język łatwy do czytania (w Polsce używa się skrótu ETR). Umowę podpisano 26 lutego 2026 roku na 24 miesiące, do lutego 2028 roku, a prace podzielono na osiem etapów.

Telefon odczytuje tekst ze zdjęcia pisma na urządzeniu za pomocą Google ML Kit i Apple Vision, a dokumenty PDF przechodzą osobny potok na serwerze. Słowniczek wyjaśnia trudne słowa w kontekście zdania, synteza mowy czyta wynik na głos i podświetla czytany fragment, opcja „uprość bardziej” daje kolejny poziom uproszczenia, a historia przechowuje wcześniejsze uproszczenia i eksportuje je do DOCX. Przed syntezą mowy krok normalizacji rozwija skróty, daty i liczby oraz dopasowuje polskie liczebniki do liczonych rzeczowników.

Specyfikacja wymaga WCAG 2.2 na poziomie AAA, a późniejsze etapy obejmują testy dostępności z czytnikami ekranu oraz w plikach DOCX generowanych przez aplikację. Dostępność ma też wymiar prawny. Europejski akt o dostępności (dyrektywa (UE) 2019/882) dotyczy od 28 czerwca 2025 roku m.in. usług bankowości detalicznej, a w Polsce stosuje się ustawę z 26 kwietnia 2024 roku o zapewnianiu spełniania wymagań dostępności.

Jak sprawdzamy, czy wyniki AI są wystarczająco dobre

Miara, człowiek, testy jailbreak albo backtest, zależnie od projektu
ProjektJak sprawdzamyKto sprawdza
PSONI, jakość uproszczeniaSkrypt w Pythonie ocenia każdy wynik indeksem Gunning Fog, który szacuje, ile lat nauki wymaga tekst. Indeks powstał dla angielskiego, więc na polskim tekście pokazuje trend między wersjami. Pierwszy potok oceny, z promptem systemowym i zbiorczym raportem na syntetycznych próbkach, dostarczyliśmy w czerwcu 2026 rokuRecenzent przeszkolony w standardzie ETR ocenia prawdziwe wyniki na tle ich źródeł, a redaktorzy sprawdzają zbiór tekstów stojący za próbkami w osobnym serwisie online
PSONI, każda iteracjaKażda iteracja ma określone cele, na przykład rozwijanie skrótów i zastępowanie zbyt trudnych słów. Wraz z nią powtarzają się testy jailbreak: próbują odciągnąć model od zadania, na przykład prosząc o przepis na szarlotkę zamiast uproszczonego pismaQA
PSONI, czytanie na głos i teksty prawneNormalizację dla mowy sprawdzamy na stałym tekście wzorcowym z liczebnikami, liczebnikami porządkowymi, dekadami, cyframi rzymskimi, zakresami i liczbami ujemnymi. Przy tekstach prawnych i medycznych aplikacja pokazuje informację, że uproszczona wersja nie jest dokumentem prawnym, a szczegóły może wyjaśnić prawnik lub lekarzStały tekst wzorcowy i informacja w aplikacji
EneraceKażde podsumowanie ma status: nowe, w toku, wygenerowane lub potwierdzone; do raportów i listy wiadomości w aplikacji trafiają tylko potwierdzoneRedaktor
Centrum KomunikacjiUżytkownik widzi wyłącznie poprawiony tekstSpecjalista od transkrypcji
Platforma remontowaRundy analizy prawdziwych rozmówNasz zespół
Prognozy sprzedażyBramka modelu i backtest na zakończonych już sprzedażach dla każdej rekomendacjiBramka modelu w potoku
Nasz serwer MCPKody odpowiedzi po stronie serwera blokują stronę bez briefu oraz publikację z błędami audytuSerwer, a każdy brief zatwierdza człowiek

Kiedy projekt nie potrzebuje modelu językowego

Projekt nie potrzebuje modelu językowego, gdy zadanie rozwiązują modele statystyczne, jak w naszym systemie prognozowania sprzedaży dla firmy z branży wydarzeń na żywo. Klientem jest kolejna anonimowa firma z tego rynku, a modele są trenowane i walidowane na jej danych o sprzedaży biletów. Projekt ruszył we wrześniu 2026 roku od krótkiego studium technicznego źródeł danych. Sprzedaż biletów pochodzi z serwisu wydarzeń klienta, platformy biletowej, międzynarodowego agregatora wydarzeń i arkusza klienta, a trafia do hurtowni danych zbudowanej w dlt i dbt na ClickHouse i orkiestrowanej w Dagsterze.

Model prognozuje końcową sprzedaż wydarzenia na podstawie porównywalnych, zakończonych krzywych sprzedaży, z przedziałem empirycznym, a gdy porównywalnych krzywych jest mniej niż pięć, nie podaje prognozy. Liczy też tempo sprzedaży względem mediany porównywalnych wydarzeń, ryzyko wyprzedania i anomalie w koszyku, a analiza obejmuje wpływ pogody na frekwencję i sprzedaż.

Trenowanie i walidację zamknęliśmy 20 października 2026 roku, a wyniki trafiają do portalu z listą wydarzeń, planem sprzedaży i oceną „jak idzie”, z kontami użytkowników i rolami.

Czy zadanie wymaga modelu językowego, rozstrzyga się w discovery. Nasza strona o proof of concept i MVP w AI oraz artykuł o tworzeniu proof of concept dla AI pokazują, jak to testujemy, zanim powstanie cała aplikacja.

Technologie, których używamy

Warstwa modelu działa obok zwykłego oprogramowania aplikacyjnego. Każda pozycja nazywa narzędzia jednej warstwy i projekt, w którym działają.

  1. Modele i serwowanie

    Gemma 4 26B A4B serwowana przez vLLM, z PLLuM 12B przetestowanym jako alternatywa, w PSONI. Skrypty Bash i Docker uruchamiają instancje GPU w powtarzalny sposób. vLLM przechowuje pamięć podręczną klucz-wartość uwagi w blokach o stałym rozmiarze (PagedAttention) i udostępnia API HTTP zgodne z OpenAI, więc kod napisany pod hostowane API można skierować na samodzielnie hostowany model, zmieniając bazowy adres URL i nazwę modelu.

  2. Funkcje dostępności

    Google ML Kit i Apple Vision odczytują tekst ze zdjęć na urządzeniu, osobny potok obsługuje pliki PDF na serwerze, a synteza mowy podświetla czytany fragment. Wszystko to działa w PSONI.

  3. Ochrona danych

    Microsoft Presidio anonimizuje teksty. W Generatorze ETR wrażliwe dane są szyfrowane za pomocą Fernet, pliki leżą w prywatnym buckecie z szyfrowaniem w spoczynku, a treści mają domyślny okres przechowywania 30 dni. W Centrum Komunikacji pola osobowe są szyfrowane kluczem symetrycznym, a dane użytkownika można na żądanie usunąć nieodwracalnie, z zapisem, kto to zrobił, kiedy i na jakiej podstawie.

  4. Aplikacje i backend

    Django, Django REST Framework i Celery obsługują API i zadania w tle, a React i React Native budują aplikacje webowe i mobilne, w PSONI. Enerace dodaje API GraphQL, TypeScript i AWS.

  5. Dane i prognozowanie

    dlt i dbt na ClickHouse ładują i modelują dane biletowe, Dagster je orkiestruje, a PostgreSQL i Next.js obsługują portal, z Traefikiem na krawędzi. Kod żyje w monorepo z Dockerem i CI. To projekt prognozowania sprzedaży.

  6. Komunikacja w czasie rzeczywistym

    Centrum Komunikacji działa na Django, React i React Native (Expo), samodzielnie hostowanym LiveKit z szyfrowaniem end-to-end i LiveKit SIP do połączeń, klastrze PostgreSQL z failoverem, Redis Sentinel i S3. Kluczowe komponenty są open source, a hosting i dane zostają w UE.

  7. Serwer MCP

    Nasz serwer produkcyjny, działający od 9 lipca 2026 roku, miał 20 października 2026 roku 164 narzędzia, od stron i SEO po media, przekierowania, analitykę i leady. Używa oficjalnego MCP SDK dla Pythona (FastMCP), ze stdio lokalnie i streamable HTTP na produkcji, jako cienkiej warstwy nad REST API CMS-a, więc walidacja i uprawnienia żyją w API. Docker bez uprawnień roota, health check /healthz, nginx z TLS, Swagger UI i schemat OpenAPI.

  8. Publiczny endpoint MCP

    Endpoint pod adresem ordergroup.co/mcp jest bezstanowy: każde wywołanie to jeden POST z komunikatem JSON-RPC, a odpowiedź to JSON bez sesji. Jest otwarty bez tokenu od 8 października 2026 roku i figuruje w oficjalnym rejestrze MCP jako co.ordergroup/public.

  9. Przebieg proof of concept

    Najpierw powstaje frontend, z interaktywnym podglądem zbudowanym w v0.dev (React, Shadcn UI i Tailwind CSS). Potem Cursor IDE generuje endpointy backendu, które go obsługują, na przykład widoki i serializery Django albo FastAPI.

Słownik

Pojęcia AI wyjaśnione

Pojęcia stojące za tą stroną, każde z własnym hasłem.

  • Ewaluacja modeli językowych (LLM evaluation)

    Ewaluacja modeli językowych (LLM evaluation) to systematyczne sprawdzanie odpowiedzi modelu na stałym zestawie wejść według uzgodnionych kryteriów odbioru, testami automatycznymi, oceną przez inny model i przeglądem przez ludzi. Rozstrzyga, czy model, prompt albo wersja nadaje się do wdrożenia.

  • Lokalny model językowy (self-hosted LLM)

    Lokalny model językowy (self-hosted LLM) to duży model językowy, którego wagi działają na infrastrukturze pod Twoją kontrolą, na własnych serwerach albo wynajętych GPU. Zapytania i odpowiedzi nie trafiają do dostawcy modelu.

  • MCP (Model Context Protocol)

    Model Context Protocol

    Model Context Protocol (MCP) to otwarty standard, który łączy aplikacje AI z zewnętrznymi źródłami danych i narzędziami. Serwer MCP publikuje listę narzędzi z nazwą, opisem i schematem danych wejściowych, a klient AI pyta, co jest dostępne, i pozwala modelowi wybrać.

  • Tekst łatwy do czytania (ETR)

    Tekst łatwy do czytania i zrozumienia

    Tekst łatwy do czytania (ETR) to sposób pisania, dzięki któremu osoby z niepełnosprawnością intelektualną rozumieją informacje: codzienne słowa, krótkie zdania, jedna myśl w linii i sprawdzenie tekstu przez czytelników z tej grupy. Europejski standard publikuje Inclusion Europe.

  • WCAG 2.2

    Web Content Accessibility Guidelines 2.2

    WCAG 2.2 to standard W3C dotyczący dostępności treści internetowych. Zawiera 86 sprawdzalnych kryteriów sukcesu na trzech poziomach: A, AA i AAA. Treść zgodna z WCAG 2.2 spełnia też wersję 2.1, do której na poziomie AA odsyłają przepisy UE i Polski o stronach i aplikacjach.

  • AI Act

    Akt w sprawie sztucznej inteligencji, rozporządzenie (UE) 2024/1689

    AI Act, czyli rozporządzenie (UE) 2024/1689, to unijne prawo, które dzieli systemy AI według ryzyka. Zakazuje niektórych praktyk, stawia wymogi systemom wysokiego ryzyka, np. scoringowi kredytowemu osób fizycznych, nakłada obowiązki przejrzystości i reguluje modele AI ogólnego przeznaczenia.

  • Anonimizacja danych

    Anonimizacja danych to przetworzenie danych osobowych tak, że nikt nie zidentyfikuje osoby żadnym racjonalnie prawdopodobnym sposobem. Dane anonimowe są poza RODO, a dane spseudonimizowane, które da się znów powiązać z osobą dzięki osobno trzymanym informacjom, nadal są danymi osobowymi.

  • Europejski akt o dostępności (EAA)

    Europejski akt o dostępności, dyrektywa (UE) 2019/882

    Europejski akt o dostępności (EAA), dyrektywa (UE) 2019/882, to prawo UE, które nakazuje, by wybrane produkty i usługi dla konsumentów, np. sklepy internetowe, bankowość detaliczna, e-booki i aplikacje przewoźników, były dostępne dla osób z niepełnosprawnościami. Obowiązuje od 28 czerwca 2025 r.

  • Testy z czytnikiem ekranu

    Testy z czytnikiem ekranu (VoiceOver, TalkBack, NVDA)

    Testy z czytnikiem ekranu to sprawdzanie aplikacji lub strony VoiceOverem, TalkBackiem lub NVDA, czyli programami, dzięki którym osoby niewidome i słabowidzące słyszą interfejs. Tester sprawdza na każdym ekranie, co jest odczytywane, w jakiej kolejności i czy da się dokończyć każde zadanie.

Jak zaczyna się projekt AI u nas i do kogo należy kod

Projekt AI zaczyna się od bezpłatnych warsztatów discovery, trwa w dwutygodniowych sprintach i kończy kodem, który należy do Ciebie. Zespół prowadzący discovery buduje potem produkt, więc zakres i decyzje nie są przekazywane drugi raz. Na warsztatach potrzebny jest Twój Product Owner albo decydent potwierdzający zakres, a po naszej stronie uczestniczą Project Tech Leader i Business Owner, z Product Designerem, gdy projekt ma warstwę UX lub UI.

Faza Discovery w PSONI trwała od 17 marca do 15 czerwca 2026 roku, ze sprintami Discovery i sprintami nad proof of concept AI, a zakończyła się demem i dokumentacją odbiorową etapu. Rozszerzone discovery, czyli osobny i szerszy zakres, daje pisemne podsumowanie, potwierdzony zakres, mapy ścieżek i przepływów użytkowników, makiety lub klikalny prototyp, backlog i user stories.

Projekt rusza potem kick-offem z klientem. Uzgadniamy metodykę, zakładamy YouTrack i kanały komunikacji oraz przydzielamy role Project Tech Leadera, Product Ownera i opcjonalnie Scrum Mastera. Praca toczy się w dwutygodniowych sprintach Agile, z których każdy kończy się działającym demem.

Projekt serwera MCP kończy się kodem źródłowym, zautomatyzowanymi testami API, dokumentacją API jako schematem OpenAPI, obrazem Dockera gotowym do wdrożenia i dziennikiem wywołań, jak opisuje nasza strona o tworzeniu serwerów MCP. Prawa autorskie do kodu przechodzą na Ciebie wraz z każdą płatnością, w polach eksploatacji wskazanych w umowie, a kod Generatora ETR należy do PSONI. Po uruchomieniu zostajemy przy wsparciu i utrzymaniu, bo modele, prompty i dane stale się zmieniają.
Jak wybrać firmę od rozwoju AI

Dobra firma od rozwoju AI odpowiada na te pytania nazwanymi projektami i faktami. Nasze odpowiedzi są w sekcjach powyżej.

  • Jakie projekty potrafią wskazać?

    Szukaj nazwanych projektów z modelem i prawdziwymi danymi oraz osoby, która sprawdza wyniki.

  • Jak wybierają model?

    Szukaj testu na prawdziwym zadaniu, z nazwanymi kandydatami i danymi.

  • Gdzie działa model?

    Szukaj jasnego miejsca dla modelu i odpowiedzi, co dzieje się z danymi przechowywanymi wokół niego.

  • Do kogo należy wynik?

    Szukaj kodu źródłowego i przejścia praw do kodu na Ciebie wraz z projektem.

  • Jak zaczyna się praca?

    Szukaj pierwszego kroku, który kończy się zakresem, wyceną i testem sukcesu.

  • Co dzieje się po uruchomieniu?

    Szukaj wsparcia i utrzymania, bo modele, prompty i dane stale się zmieniają.
Wybrane realizacje

Case studies stojące za tymi systemami AI

Od czego zacząć

Na jakim etapie jest Twój projekt AI?

Wybierz sytuację najbliższą Twojej. Każda zaczyna się od bezpłatnych warsztatów discovery.

Nasze dane nie mogą opuszczać naszej infrastruktury

Pierwszy krok

Ustal, gdzie model może działać

Sprawdzamy, co model czyta, gdzie może działać i kto ma dostęp do przechowywanych tekstów, a potem dobieramy model i serwery GPU do spodziewanego ruchu.

  1. Bezpłatne warsztaty discovery o Twoich danych i zasadach
  2. Wybór między modelem hostowanym a API dostawcy
  3. Zakres, wycena i określony test sukcesu

Chcemy dodać AI do działającego produktu

Pierwszy krok

Zmapuj, gdzie pasuje funkcja AI

Przyglądamy się produktowi, danym i zadaniu wraz z jego testem i proponujemy osobną usługę AI, którą wywołuje backend.

  1. Bezpłatne warsztaty discovery o Twoim produkcie
  2. Proof of concept na Twoim prawdziwym zadaniu
  3. Wycena pierwszego wydania
Porozmawiasz z Łukasz Gajownik Head of AI & Frontend

Potrzebujemy funkcji dostępności zbudowanych z AI

Pierwszy krok

Ustal, kto sprawdza każdy wynik

Określamy grupę użytkowników, standard do spełnienia i osobę, która sprawdza każdy wynik, zanim zobaczą go użytkownicy: przeszkolonego recenzenta, specjalistę albo redaktora.

  1. Bezpłatne warsztaty discovery o Twoich użytkownikach i zasadach
  2. Miara jakości i recenzent wyników
  3. Wycena pierwszego wydania

Masz pytania?

Firma tworząca oprogramowanie AI - FAQ

  • Oprogramowanie, w którym model językowy wykonuje konkretną pracę dla prawdziwych użytkowników. Obejmuje to prywatne i on-premise LLM, agentów AI i chatboty, integrację AI z istniejącymi produktami, proof of concept i MVP w AI oraz serwery MCP. Budujemy też aplikacje webowe i mobilne wokół modelu.

  • To zależy od zadania. W naszych projektach z modelami językowymi zachowanie wynika z doboru modelu, promptów i oceny jakości. W prognozach sprzedaży trenujemy i walidujemy modele statystyczne na danych klienta, a dla PSONI rozważamy wytrenowanie HerBERT, polskiego modelu językowego, do wykrywania danych osobowych. Potrzebę dotrenowania oceniamy w bezpłatnym discovery.

  • Tak. Dodajemy AI jako osobną usługę obok produktu, jak w naszych usługach integracji AI. W Enerace podsumowania AI pojawiły się bez przepisywania platformy, co opisuje case study Enerace. Koszt wywołań modelu zależy od liczby nowych wiadomości, a nie od liczby odwiedzin.

  • Tak, gdy pozwala na to konfiguracja. W Generatorze ETR administrator zmienia adres modelu, klucz, nazwę modelu, temperaturę i maksymalną liczbę tokenów w Django Admin, więc nowy model lub serwer GPU nie wymaga nowego wdrożenia.

  • Model wybiera narzędzia po ich nazwach, opisach i typowanych schematach wejścia, a kodu narzędzia nigdy nie widzi. Na naszym serwerze każde narzędzie wywołuje endpoint API CMS-a, więc walidacja i uprawnienia zostają w jednym miejscu.

  • W Generatorze ETR Microsoft Presidio tworzy zanonimizowaną kopię tekstu tylko wtedy, gdy użytkownik nie sprzeciwił się wykorzystaniu jego tekstów do trenowania AI, a zanonimizowane teksty można wyeksportować jako jeden plik JSON do zbudowania korpusu treningowego. We wrześniu 2026 roku QA potwierdziło na stagingu, że zaplanowane zadanie usuwania działa: tekst z 24 sierpnia był dostępny 23 września i został wyczyszczony następnego dnia.

  • Samo to nie wystarcza. RODO obejmuje też to, co system przechowuje, jak długo i kto ma do tego dostęp, więc te pytania omawiamy w discovery. W naszych projektach wymagania stały się funkcjami: szyfrowaniem, domyślnym okresem przechowywania 30 dni i nieodwracalnym usuwaniem na żądanie.

  • Od 2 grudnia 2027 roku dla systemów wymienionych w załączniku III, takich jak scoring kredytowy osób fizycznych, na podstawie rozporządzenia (UE) 2026/1744, czyli pakietu Digital Omnibus on AI. Systemy objęte załącznikiem I podlegają przepisom od 2 sierpnia 2028 roku. AI Act (rozporządzenie (UE) 2024/1689) dzieli systemy AI według poziomu ryzyka.

Łukasz Gajownik

Head of AI & Frontend

Bezpłatne warsztaty discovery o AI

Czytaj więcej

Artykuły o AI z naszego bloga

Firma tworząca oprogramowanie AI

Oprogramowanie AI zbudowane dla prawdziwych użytkowników i rygorystycznych zasad dotyczących danych

Twoja wiadomość trafi do

Filip Szamborski

Filip Szamborski

Co-founder & CEO

Dziękujemy za wiadomość.

Każdą wiadomość czytamy sami i odpowiadamy w ciągu 48 godzin w dni robocze.

Coś pilnego? hello@ordergroup.co

Zbudujmy Twój produkt AI

Opowiedz nam o swoim pomyśle. Odezwiemy się w ciągu 48 godzin w dni robocze.

Pola oznaczone gwiazdką (*) są wymagane.

Order Group sp. z o.o. wykorzysta podane dane tylko po to, żeby odpowiedzieć na Twoje zapytanie i zachować informację o nim (art. 6 ust. 1 lit. b i f RODO). Szczegóły, w tym Twoje prawa, znajdziesz w naszej Polityce prywatności (otwiera się w nowej karcie).

Odpowiadamy w ciągu 48 godzin w dni robocze - człowiek, nie autoresponder.

Korzystasz z asystenta AI? Może wysłać to zapytanie za Ciebie albo przygotować wypełniony formularz - instrukcję znajdzie w llms.txt.

DOTYCHCZAS PRACOWALIŚMY Z MARKAMI TAKIMI JAK:

Ustawienia dostępności

Rozmiar tekstu

100%