
Usługi integracji AI: dodaj AI do produktu, który już masz
Nowa funkcja AI nie może zepsuć działającego produktu ani pokazać użytkownikom treści, której nikt nie sprawdził. Dodajemy AI do produktów webowych i mobilnych jako osobną usługę AI, którą wywołuje Twoja aplikacja, a wynik sprawdza człowiek albo test.
Powiedz nam, co budujesz.
Kilka szczegółów pozwoli nam zaprosić na pierwszą rozmowę właściwych inżynierów.


Integracja AI z produktami, które już działają
Co dodaliśmy w każdym i jak to się łączy
Cztery integracje w produktach działających i w budowie
Enerace i Centrum Komunikacji dostały funkcje AI w platformach, które już działały.
Platforma z rynku remontów pokazuje osobną usługę, a Generator ETR wymienny model.
Czytaj więcej
Jak wygląda każda integracja
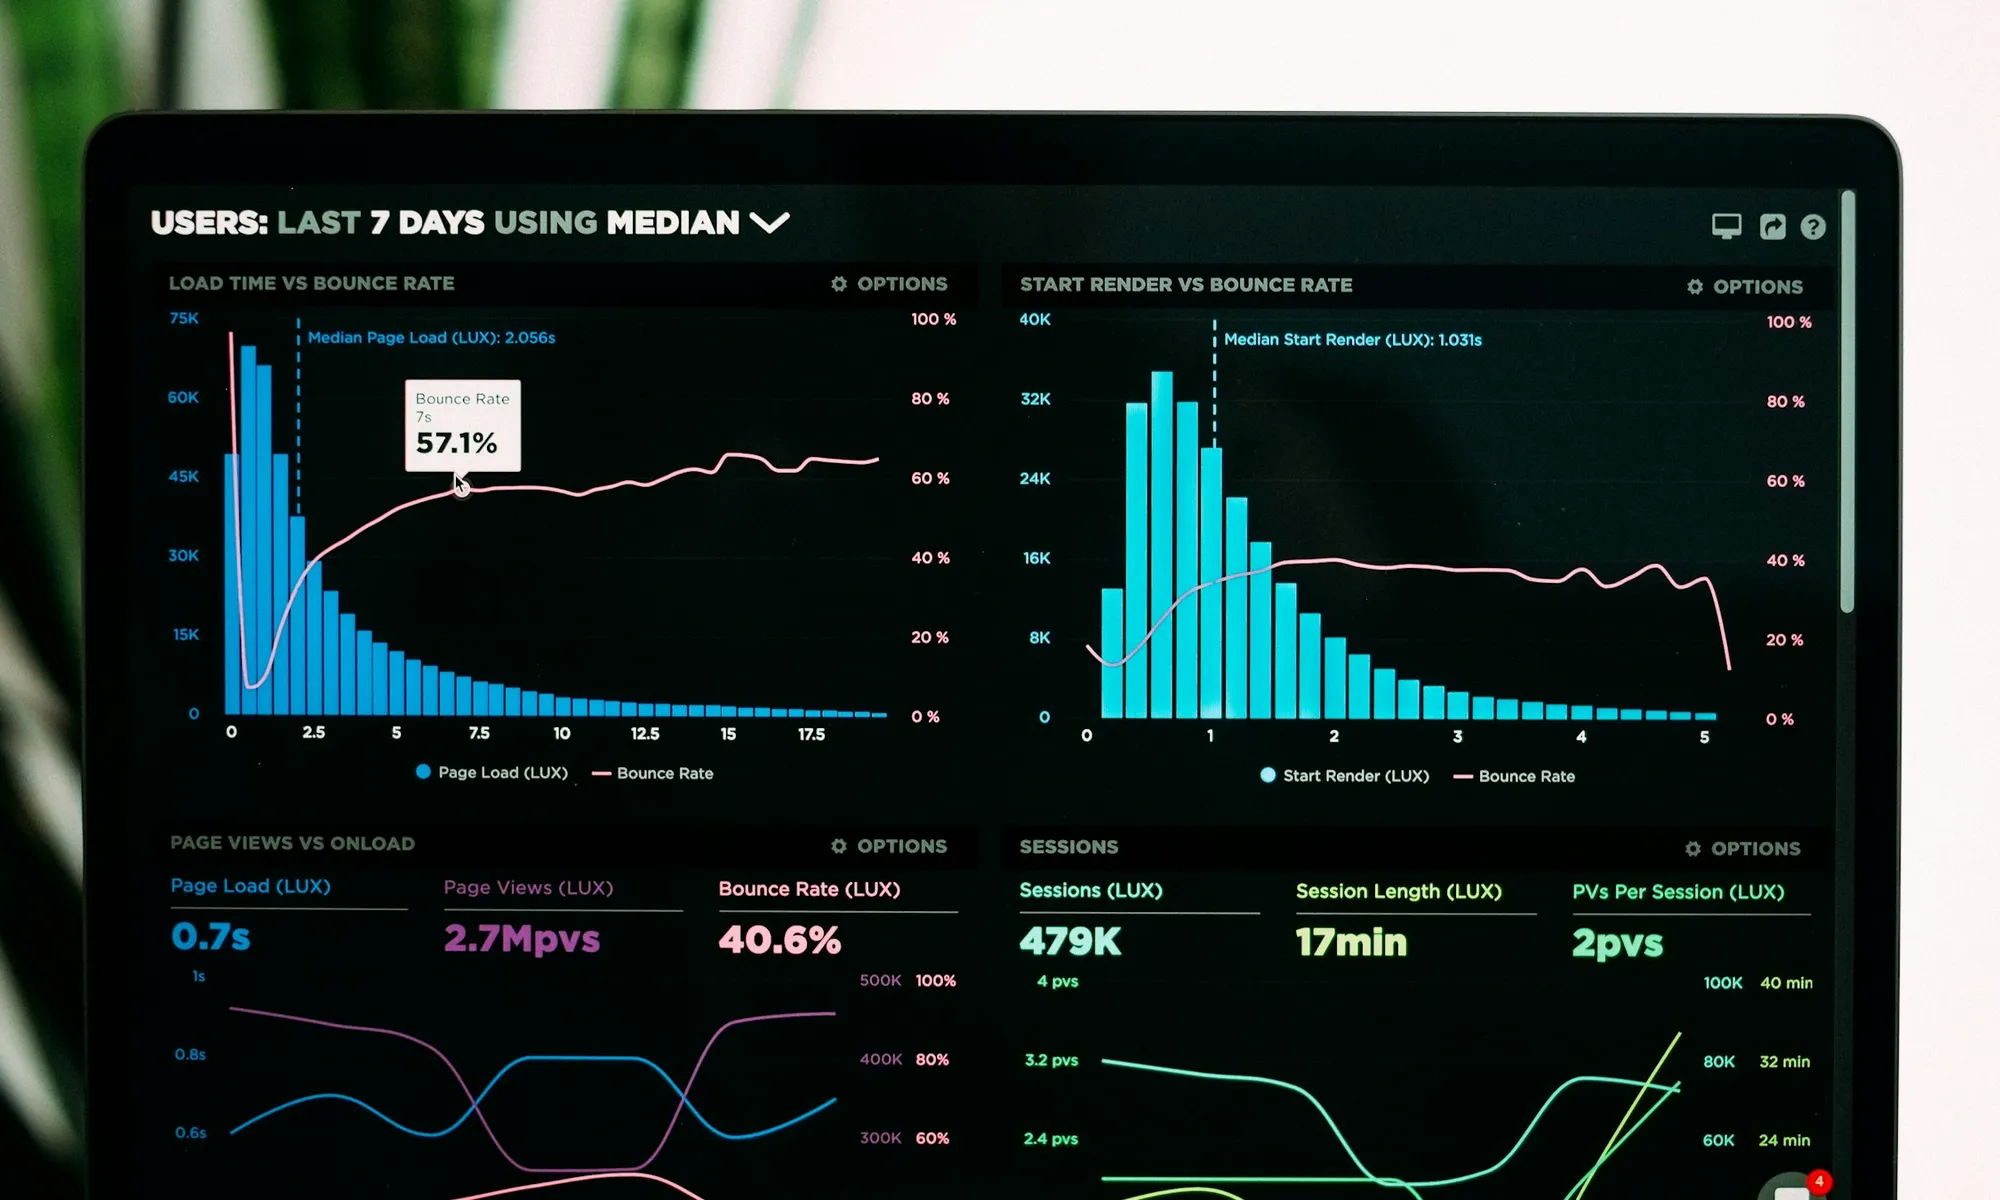
Od 2020 roku budujemy i rozwijamy Enerace.Online, platformę doradztwa w zakupach energii i gazu dla odbiorców przemysłowych. W analizie rynku newsy są przypięte do wykresów cen, a każdy news dostaje podsumowanie wygenerowane przez AI w chwili dodania. Funkcja działa na żywo od 2025 roku w produkcie z ponad 20 obszarami funkcjonalnymi w jednym kodzie i powstała bez przepisywania platformy. Technologia to Python i Django z API GraphQL, React z TypeScriptem, React Native, Celery i AWS.
Centrum Komunikacji prowadzi platformę tłumaczenia na polski język migowy (PJM), którą budujemy w rządowym programie dostępności (zobacz case study). Dodaliśmy do niej transkrypcję mowy na żywo dla osób słabosłyszących i późno ogłuchłych. Automatyczne rozpoznawanie mowy pisze w czasie rzeczywistym pierwszą wersję tekstu, specjalista ds. transkrypcji ją poprawia i dopiero poprawiony tekst trafia do użytkownika jako wiadomość na czacie. Funkcja działa na produkcji. Dane osobowe chronią szyfrowane pola, możliwość usunięcia danych użytkownika i dziennik zdarzeń.
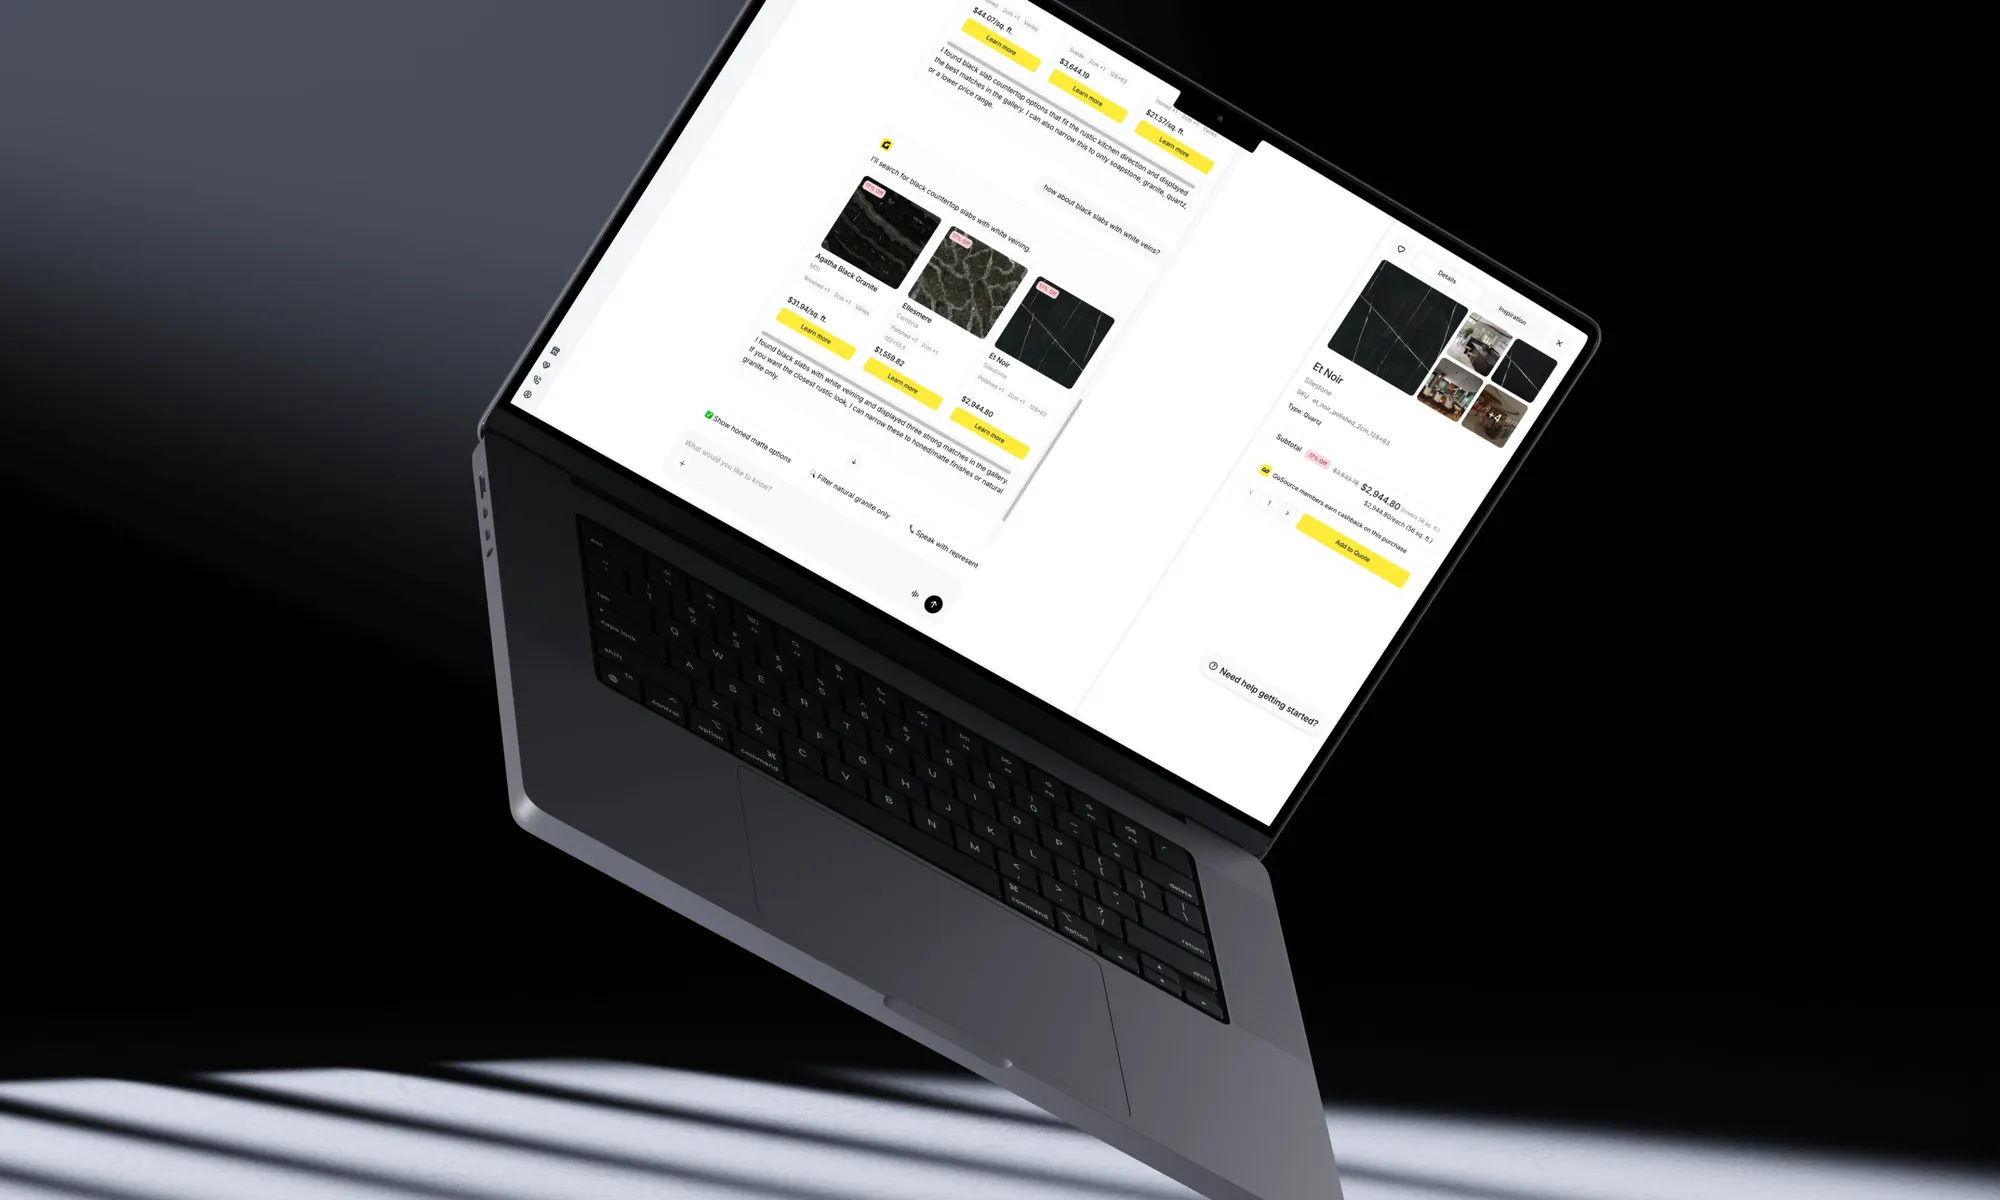
Na platformie produktowej z rynku remontów i wyposażenia wnętrz czat AI i agent wyszukiwania produktów działają w osobnej usłudze AI.
W Generatorze ETR dla PSONI telefon odczytuje tekst ze zdjęcia pisma na samym urządzeniu. Dokumenty PDF idą osobną ścieżką po stronie serwera, zanim trafią do modelu. Sam odczyt wykonują gotowe biblioteki systemowe, Google ML Kit i Apple Vision. Połączenie z modelem, odczyt tekstu i miara czytelności już działają, a API dla innych systemów jest jeszcze w budowie.
Część AI działa poza aplikacją
Integracja LLM: osobna usługa AI, którą wywołuje aplikacja
Twój backend wywołuje usługę AI przez własną warstwę serwisową.
Model stoi za nią i można go zmienić bez ruszania aplikacji.
Czytaj więcej
Osobna usługa AI to nasza domyślna architektura przy integracji LLM. Backend aplikacji ma warstwę serwisową, która ją wywołuje, więc część AI możemy mierzyć, zmieniać albo wyłączać bez ruszania reszty produktu.
Na platformie z rynku remontów AI włącza flaga na poziomie projektu (ai_enabled), więc funkcję można wyłączyć bez zmian w reszcie produktu.
Wymiana modelu bez ponownego wdrażania aplikacji
W Generatorze ETR dla PSONI połączenie z modelem to ustawienie. W panelu Django Admin administrator zmienia adres, klucz, nazwę modelu i parametry generowania, takie jak temperature i max_tokens, a kontenery backendu cały czas działają. Zmiana modelu nie wymaga więc nowego wydania aplikacji.
Wybór modelu za usługą to osobna decyzja. Z API dostawcy modelu zaczniesz szybciej. Gdy dane nie mogą opuścić Twojej infrastruktury, hostujemy model sami. Więcej na naszej stronie o prywatnym LLM. W obu przypadkach część AI zostaje osobną usługą.
API dla innych systemów i serwer MCP
Udostępnienie funkcji AI innym systemom
Funkcja AI w PSONI dostaje API dla innych systemów.
Agenci AI docierają do produktu przez serwer MCP.
Czytaj więcej
- Tworzenie serwerów MCP
- Tworzenie agentów AI
Zgodnie z decyzją PSONI API dla innych systemów będzie miało cztery endpointy: logowanie z tokenem, generowanie tekstu łatwego do czytania, listę tekstów użytkownika i podgląd tekstu historycznego, który przechowujemy 30 dni. Dostęp wymaga klucza API z panelu Django Admin, a endpointy można później wyłączyć.
Żeby podłączyć agentów AI do istniejącego produktu, budujemy serwer MCP (Model Context Protocol, standard, dzięki któremu agenci AI wywołują funkcje produktu) jako cienką warstwę nad jego REST API. W naszym CMS każde narzędzie MCP wywołuje endpoint API, więc walidacja, uprawnienia i log zostają w API. Agentów i asystentów czatu opisujemy na stronie Tworzenie agentów AI, a sam serwer na stronie Tworzenie serwerów MCP.
Gdzie wyniki AI sprawdza człowiek
Tam, gdzie błędna odpowiedź ma skutki dla użytkowników, wynik sprawdza człowiek albo test. W Centrum Komunikacji do użytkownika trafia tylko tekst poprawiony przez specjalistę ds. transkrypcji. W Generatorze ETR skrypt ocenia każdy tekst indeksem Gunning Fog, czyli miarą czytelności, a recenzent tekstów łatwych do czytania ocenia rzeczywiste odpowiedzi. Przy każdej nowej wersji modelu uruchamiamy też testy jailbreak, które próbują skłonić model do złamania zasad.
Masz działający produkt i zadanie, takie jak odpowiadanie na pytania czy transkrypcja mowy? Zacznij od bezpłatnej konsultacji.
Jak przebiega projekt integracji
Gotowość na AI: co sprawdzamy przed wdrożeniem
Bezpłatna konsultacja prowadzi do bezpłatnych warsztatów discovery, które są naszą oceną gotowości na AI. Sprawdzamy cztery rzeczy.
- Produkt: co robi dziś i gdzie w nim znajdzie się funkcja AI.
- Dane: co będzie czytał model i czy te dane mogą opuścić Twoją infrastrukturę.
- Zasady: ograniczenia prawne, bezpieczeństwa i firmowe, w których działa Twój produkt.
- Zadanie i test: co ma robić AI i jaki test pokaże, że działa.
Czasem wynikiem jest rada, żeby w ogóle zrezygnować z modelu językowego. Z warsztatów wychodzisz z wiedzą, co ma robić AI i według czego ocenimy jego wynik.
Wdrożenie AI: etapy
- Discovery. Bezpłatne warsztaty z naszym własnym zestawem narzędzi AI, na których ustalamy zakres i test sukcesu.
- Osobna usługa AI. Budujemy część AI jako usługę, którą wywołuje Twój backend, więc reszta produktu zostaje nietknięta.
- Wybór modelu. API dostawcy modelu albo model uruchamiany przez nas, zależnie od tego, dokąd mogą trafić Twoje dane.
- Kontrola jakości. Test z discovery sprawdza wyniki, a tam, gdzie błąd kosztuje, ocenia je też człowiek.
- Wsparcie. Po wdrożeniu zostajemy przy wsparciu i utrzymaniu, bo modele, prompty i dane, które czytają, ciągle się zmieniają.
Zakres prac AI ustalamy na warsztatach discovery. Obejmuje on usługę AI, wybór modelu i kontrolę jej wyników. Prawa autorskie do kodu przechodzą na Ciebie z każdą płatnością, w zakresie pól eksploatacji z umowy.
Ustalony test, Twój kod, wsparcie po wdrożeniu
Dlaczego zespoły dodają AI z nami
Test sukcesu ustalamy na bezpłatnych warsztatach discovery, zanim zaczniemy budować.
Kod jest Twój z każdą płatnością, a po wdrożeniu zostajemy przy wsparciu.
Masz pytania?
Integracja AI: najczęstsze pytania
-
Obejmuje bezpłatne warsztaty discovery, osobną usługę AI wywoływaną przez Twoją aplikację, wybór między API dostawcy modelu a modelem uruchamianym przez nas, kontrolę wyników i wsparcie po wdrożeniu. To oferta dla właściciela produktu (product owner) albo CTO, którego produkt webowy lub mobilny już działa i który chce dodać AI, nie psując reszty.
-
Tak. Enerace ma podsumowanie AI każdego newsa rynkowego, dodane bez przepisywania platformy z ponad 20 obszarami funkcjonalnymi w jednym kodzie. Centrum Komunikacji dostało transkrypcję mowy na żywo w działającej platformie, a platforma produktowa z rynku remontów czat AI i agenta wyszukiwania produktów.
-
Budujemy część LLM jako osobną usługę AI, którą Twój backend wywołuje przez własną warstwę serwisową. Połączenie z modelem (adres, klucz i nazwę modelu) można ustawić w panelu Django Admin, jak w Generatorze ETR dla PSONI.
-
Tak. Na platformie produktowej z rynku remontów AI włącza flaga na poziomie projektu (ai_enabled), więc jej wyłączenie niczego innego w produkcie nie zmienia. Część AI to osobna usługa, więc można ją też mierzyć albo zmieniać niezależnie.
-
Tak. W Generatorze ETR administrator zmienia nazwę modelu, adres, klucz i parametry generowania w panelu Django Admin, a kontenery backendu cały czas działają. Zmiana modelu nie wymaga nowego wydania aplikacji.
-
API dostawcy modelu pozwala zacząć szybciej. Gdy dane nie mogą opuścić Twojej infrastruktury, hostujemy model sami. Decydujemy o tym razem z Tobą na warsztatach discovery, zależnie od tego, dokąd mogą trafić dane. O drugiej opcji piszemy na stronie o prywatnym LLM.
-
Tam, gdzie błędna odpowiedź ma skutki dla użytkowników, wynik sprawdza człowiek albo test. W Centrum Komunikacji specjalista ds. transkrypcji poprawia transkrypcję, zanim zobaczy ją użytkownik. W Generatorze ETR oceniamy teksty indeksem Gunning Fog, ocenia je też recenzent, a testy jailbreak uruchamiamy przy każdej nowej wersji modelu.
-
Tak. Zakres i architekturę systemu RAG ustalamy na warsztatach discovery. Nie opisujemy tu projektów RAG, bo są objęte NDA. Pytania są te same co przy każdej funkcji AI: co system ma robić i jaki test pokaże, że działa.
-
To sprawdzenie, które prowadzimy na bezpłatnych warsztatach discovery przed każdym wdrożeniem AI. Przyglądamy się Twojemu produktowi, danym i zasadom, w których działasz, a potem ustalamy, co ma robić AI i jaki test pokaże, że działa. Czasem odpowiedzią jest rezygnacja z modelu językowego.
-
Najpierw jest discovery, które jest bezpłatne. Potem budujemy osobną usługę AI, wybieramy między API dostawcy modelu a modelem uruchamianym przez nas, sprawdzamy wyniki testem i człowiekiem tam, gdzie błąd kosztuje, a po wdrożeniu zostajemy przy wsparciu.
-
Do Ciebie. Prawa autorskie do kodu przechodzą na Ciebie z każdą płatnością, w zakresie pól eksploatacji z umowy. Dotyczy to kodu, który piszemy na potrzeby integracji AI, zarówno w usłudze AI, jak i w Twoim backendzie.
-
To zależy od Twojego produktu. W Enerace jest to Python i Django z API GraphQL, React z TypeScriptem, React Native, Celery i AWS. W Generatorze ETR ustawienia modelu są w Django Admin, a tekst ze zdjęć odczytują na telefonie Google ML Kit i Apple Vision.
Funkcje AI dodane do produktów, które już działają.
Twoja wiadomość trafi do
Filip Szamborski
Co-founder & CEO

Twoja wiadomość trafi do
Karol Oponowicz
Co-founder & Business Owner
Twoja wiadomość trafi do
Paweł Zieliński
Co-founder & Business Owner
WSPÓŁPRACOWALIŚMY M.IN. Z MARKAMI:
Dziękujemy za wiadomość.
Każdą wiadomość czytamy sami i odpowiadamy w ciągu 48 godzin w dni robocze.
Coś pilnego? hello@ordergroup.co