Wsparcie i utrzymanie oprogramowania, które nie kończy się po starcie
Projekt zostaje wydany, ale produkt dalej się zmienia - Zeronest jest dziś na 56. sprincie wsparcia, a zaczynał od 19. Wsparcie prowadzimy tak samo jak development: dedykowani inżynierowie, dwutygodniowe sprinty i plan na wypadek, gdy coś się zepsuje.
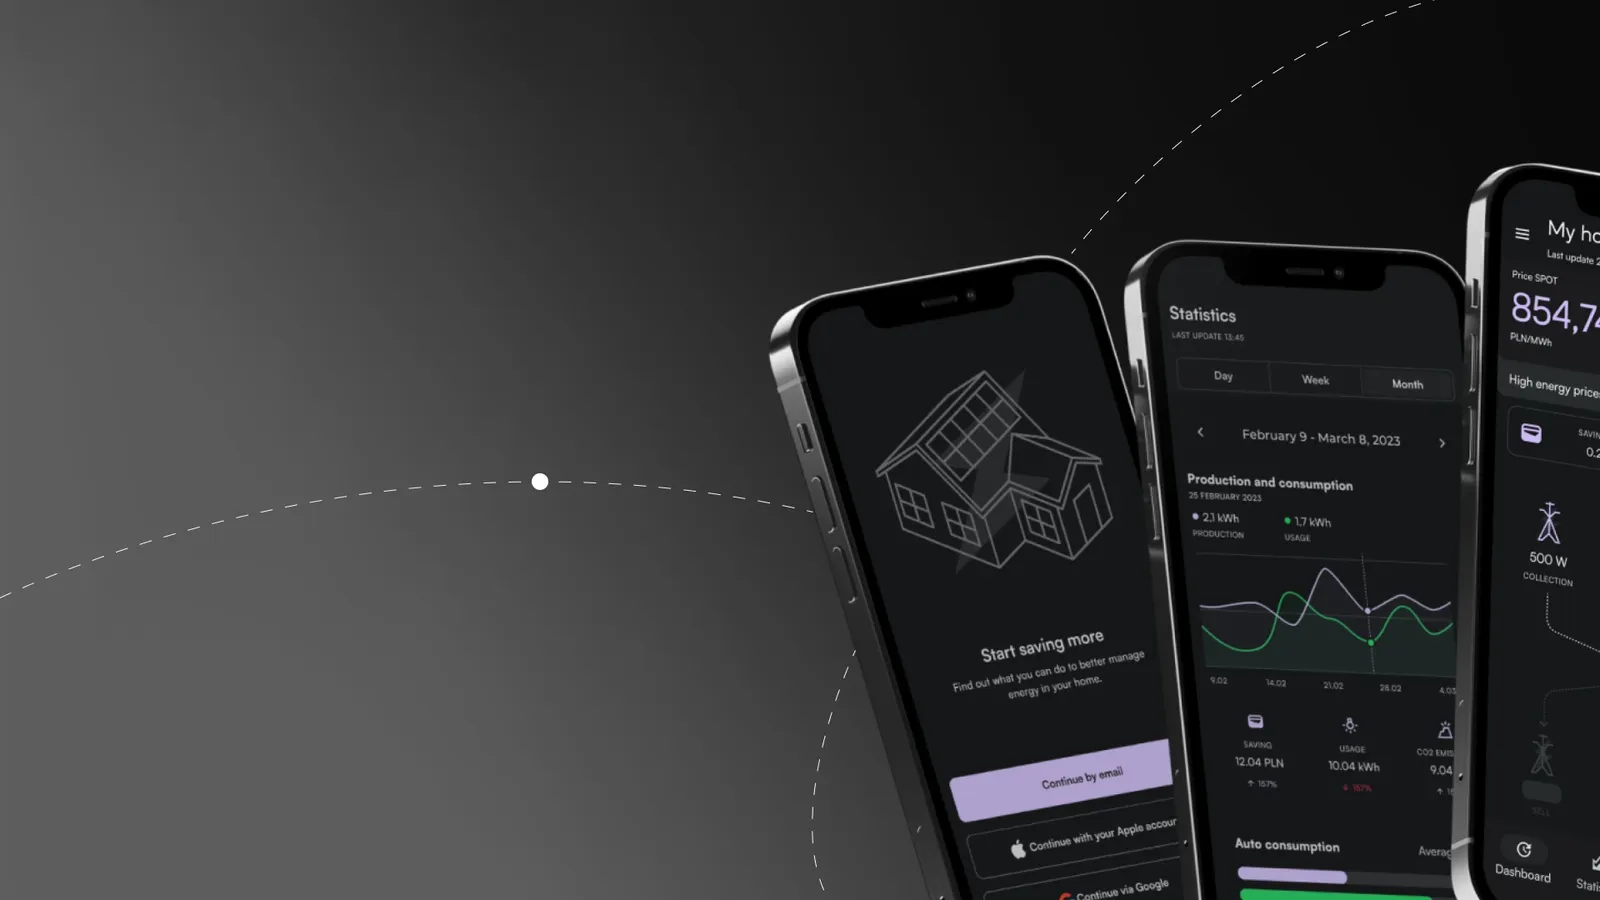
Co naprawdę obejmuje wsparcie i utrzymanie oprogramowania
Didrik Martens
BizBot CEO
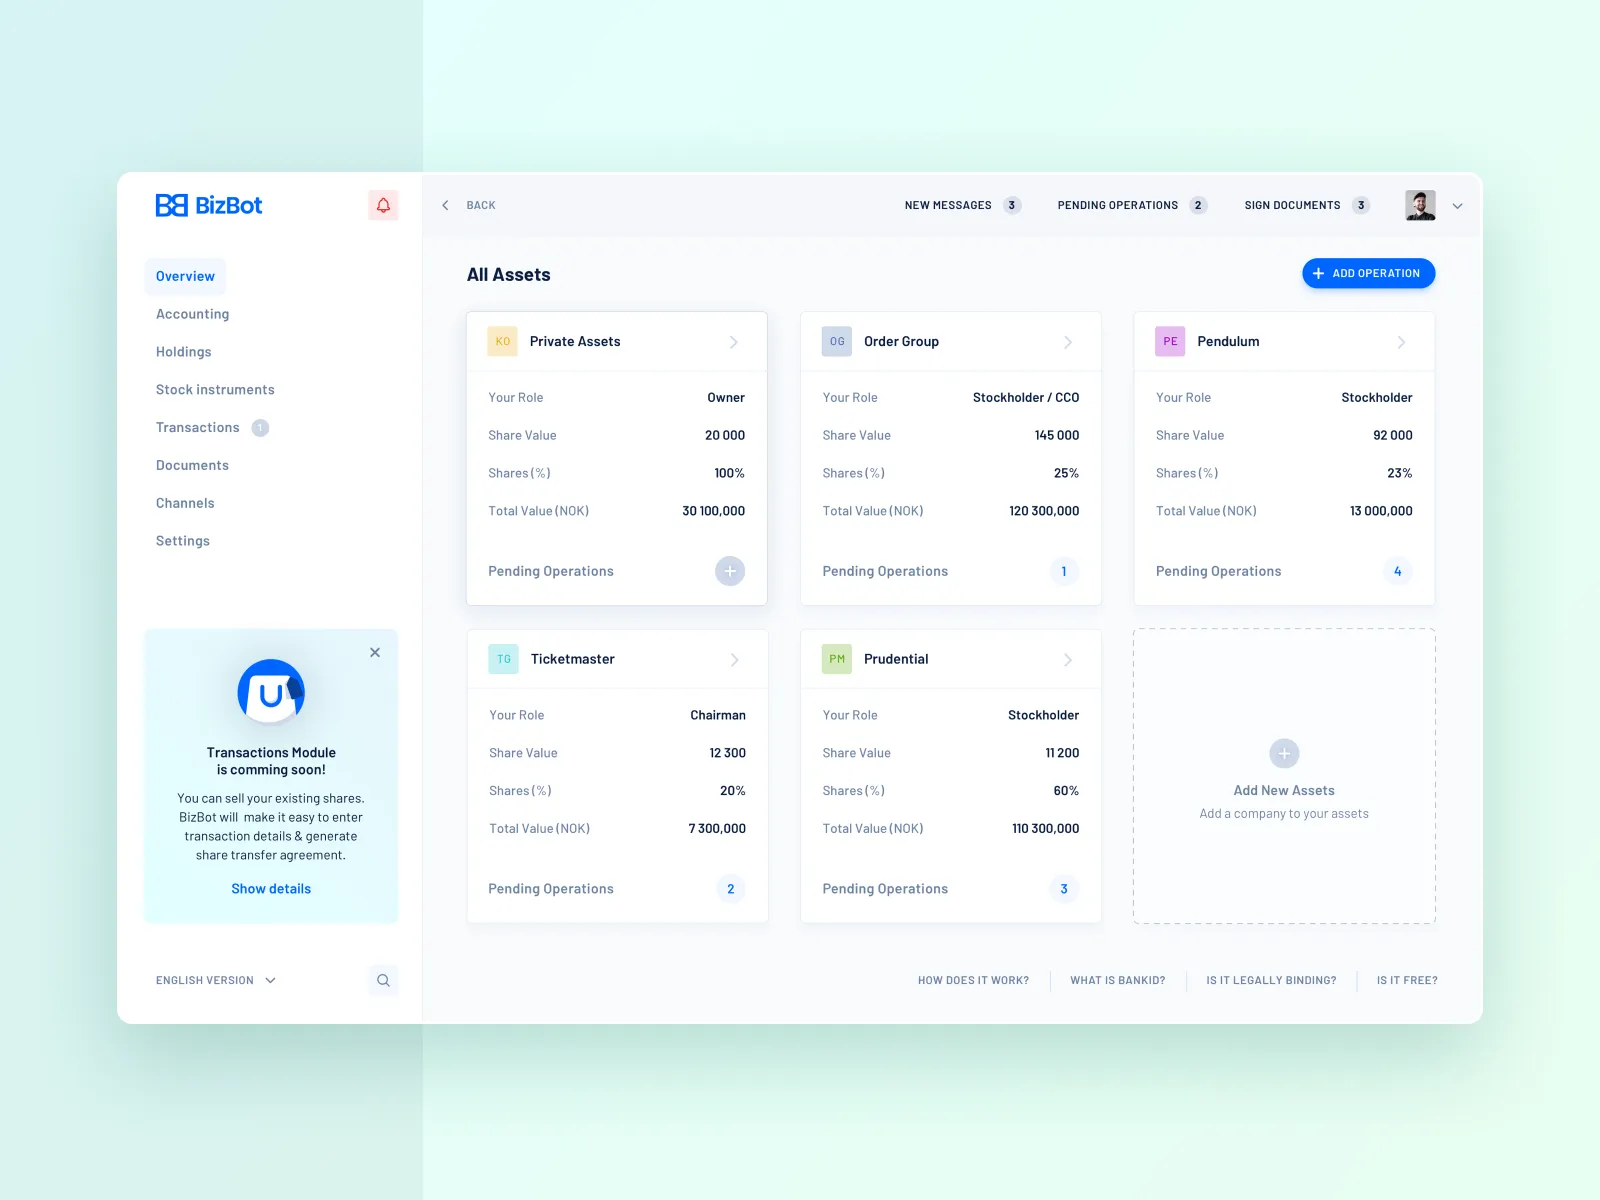
Te same trzy rzeczy, sprint po sprincie.
Jak prowadzimy bieżące utrzymanie oprogramowania
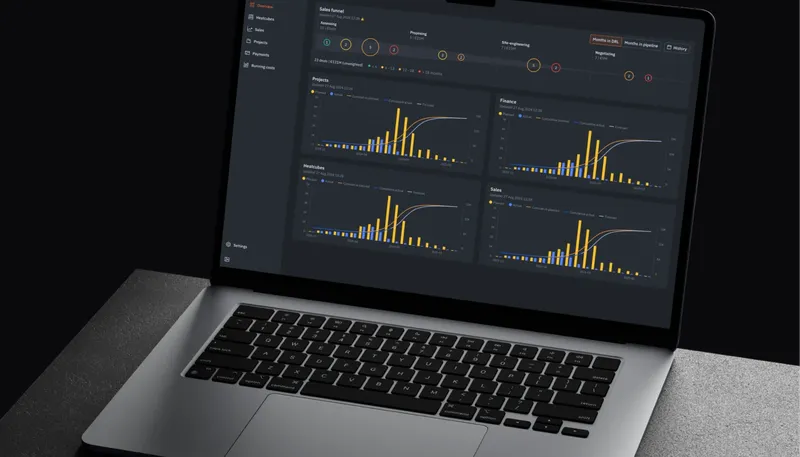
Monitoring i analiza
Śledzimy dostępność, poziom błędów i to, jak prawdziwi użytkownicy korzystają z produktu, żeby wyłapać problemy, zanim zamienią się w incydenty.
Każdy sprint zaczynamy od krótkiego przeglądu tego, co zmieniło się na produkcji od poprzedniego, więc priorytety wynikają z faktycznego użycia.
Na tym przeglądzie sygnalizujemy też dryf: przestarzałe zależności, zmiany we wzorcach ruchu i wszystko, co urośnie w większy problem, jeśli przeleży bez opieki kolejny sprint.
Nie każdy alert staje się ticketem: na przeglądzie decydujemy, co trzeba naprawić w tym sprincie, a co może poczekać, więc backlog odzwierciedla realne ryzyko, a nie każde powiadomienie, które się pojawiło.
Aktualizacje w sprintach
Poprawki i usprawnienia wydajemy w tym samym dwutygodniowym rytmie co nowy development. Na tym modelu opiera się 38 sprintów Zeronest - od sprintu 19 w maju 2025 roku do sprintu 56 w lipcu 2026 roku.
Każdy sprint kończy się działającą, wdrożoną zmianą - w tym samym rytmie, jaki widzi u nas klient budujący nowy produkt.
Małe zgłoszenia nie czekają na kwartalne spotkanie o roadmapie. Trafiają do najbliższego wolnego sprintu razem z tym, co już czeka w kolejce.
Większe zgłoszenia wyceniamy i określamy ich zakres tak samo jak nową funkcję, więc znasz koszt, zanim praca się zacznie.
Infrastruktura i reagowanie na awarie
Gdy coś psuje się na produkcji, reaguje zespół, który zna kod, a podstawą jest SLA albo umowa wsparcia ustawiona pod Twoje priorytety.
Obejmuje to też infrastrukturę pod aplikacją - serwery, wdrożenia i monitoring, czyli tę samą infrastrukturę chmurową, którą przygotowujemy przy nowych projektach.
Czasy reakcji i eskalacja
Czasy reakcji i zasady eskalacji ustalamy z góry, na piśmie, żeby nikt nie zgadywał, do kogo dzwonić o 2 w nocy, gdy coś padnie. Typowa umowa ma trzy poziomy priorytetu: krytyczne problemy na produkcji wskakują na początek kolejki, standardowe błędy planujemy na kolejny sprint, a zgłoszenia o niskim priorytecie łączymy z innymi pracami. Docelowy czas reakcji dla każdego poziomu określa sama umowa, a nie ta strona, bo zależy on od klienta i obciążenia. Jeśli problem okaże się większy, niż wskazywał poziom nadany przy zgłoszeniu, oceniamy go ponownie w tym samym sprincie, zamiast czekać na następny.
Po incydencie
Po zamknięciu incydentu opisujemy, co się stało i co zmieniamy, żeby ta sama awaria nie powtórzyła się w kolejnym kwartale. W następnym sprincie robimy też krótką kontrolę po incydencie, żeby potwierdzić, że poprawka wytrzymuje prawdziwy ruch produkcyjny.
Przejęcie istniejącego produktu
Gdy przejmujemy produkt zbudowany przez kogoś innego, pierwszy sprint to audyt, a nie przepisywanie. Mapujemy infrastrukturę, sprawdzamy pipeline'y wdrożeniowe i dostępy oraz naprawiamy wszystko, co już jest kruche, zanim zamieni się w incydent na naszej zmianie. Audyt pokazuje też, które części systemu wymagają odtąd bliższego monitorowania, więc plan reagowania odpowiada produktowi takiemu, jaki jest naprawdę, a nie takiemu, jak opisuje go pierwotna dokumentacja.
Dlaczego warto powierzyć nam utrzymanie i wsparcie
Zostajemy po starcie
Udokumentowane, nie tylko obiecane
Jeden model dla każdego produktu
Wsparcie i utrzymanie oprogramowania - odpowiedzi
-
Monitoring i analizę, planowe aktualizacje w tym samym dwutygodniowym rytmie co nowy development oraz reagowanie na incydenty w ramach umowy SLA albo godzinowej - te same trzy elementy niezależnie od tego, czy produkt to oprogramowanie na zamówienie, aplikacja mobilna czy platforma webowa.
-
Dwa modele rozliczeń, wybierane z góry w zależności od ilości pracy.
- Model SLA: stałe poziomy czasu reakcji i abonament - najlepszy przy przewidywalnej pracy ustawionej według priorytetów.
- Model godzinowy: płacisz za czas faktycznie przepracowany w każdym sprincie - najlepszy przy mniejszej albo zmiennej ilości pracy.
-
Tak. Zaczynamy od audytu, a nie od przepisywania: przeglądamy dostępy, pipeline'y wdrożeniowe i wszystko, co już jest kruche, żeby wiedzieć, co przejmujemy, zanim wyjdzie pierwsza prawdziwa poprawka.
-
Tak. Niezależnie od tego, czy chodzi o backend, aplikację mobilną, czy platformę webową, obowiązuje ten sam rytm sprintów i ta sama umowa wsparcia - jeden kontakt dla Twojego zespołu, a nie osobny dla każdej platformy.
-
Krótki opis przyczyny i poprawki, a w kolejnym sprincie kontrola, która potwierdza, że po wdrożeniu poprawka wytrzymała prawdziwy ruch.
Więcej o tym, jak prowadzimy wsparcie
Model rozliczeń, na którym opierają się te sprinty - dla tych, którzy chcą znać szczegóły
Napisz, co wymaga wsparcia
Twoja wiadomość trafi do
Filip Szamborski
Board Member

Twoja wiadomość trafi do
Karol Oponowicz
Board Member
Twoja wiadomość trafi do
Paweł Zieliński
Board Member
WSPÓŁPRACOWALIŚMY M.IN. Z MARKAMI:

Dziękujemy za wiadomość.
Każdą wiadomość czytamy sami i odpowiadamy w ciągu 48 godzin w dni robocze.
Coś pilnego? [email protected]